OpenAI Aurait Résolu Navier-Stokes En 88 Heures Avec 10 000 Agents
OpenAI affirme avoir obtenu, en seulement 88 heures, une preuve sur un problème qui résiste aux mathématiciens depuis près de 90 ans. Et le modèle à l'origine de ce résultat, ce n'est même pas GPT-6 Astra : il s'agirait d'un nouveau modèle interne, encore en cours d'entraînement, présenté comme nettement plus puissant, et déployé à travers près de 10 000 agents travaillant en parallèle. Leur objectif : résoudre une formulation du problème de Navier-Stokes, l'un des sept problèmes du millénaire, doté d'une récompense d'un million de dollars. Si le résultat est confirmé, ce serait l'une des découvertes scientifiques les plus importantes jamais produites par un modèle. Sauf que l'histoire est bien plus compliquée que ce que laisse entendre l'annonce d'OpenAI — la preuve ne résout pas forcément le problème de la manière qu'on imagine, elle s'appuie sur des travaux humains très récents, et une sérieuse controverse de priorité scientifique a déjà éclaté. On regarde ce qu'OpenAI a réellement démontré.
Les équations de Navier-Stokes, un problème vieux de 90 ans
Les équations de Navier-Stokes décrivent le mouvement des fluides : l'eau, l'air, la fumée, le sang, ou encore les turbulences autour d'un avion. On les utilise déjà dans d'innombrables simulations. Le vrai problème, c'est que personne ne sait si elles restent mathématiquement stables dans toutes les situations. Prenez un fluide dont le mouvement est parfaitement régulier au départ : est-ce que son évolution reste toujours régulière, ou est-ce qu'une zone minuscule pourrait finir par accélérer indéfiniment jusqu'à atteindre une vitesse infinie en un temps limité ? Ce point de rupture mathématique s'appelle une singularité, ou blow-up. Dans la réalité, un fluide ne peut évidemment pas atteindre une vitesse infinie — mais si une singularité peut apparaître dans les équations, ça révèle une limite fondamentale du modèle mathématique.
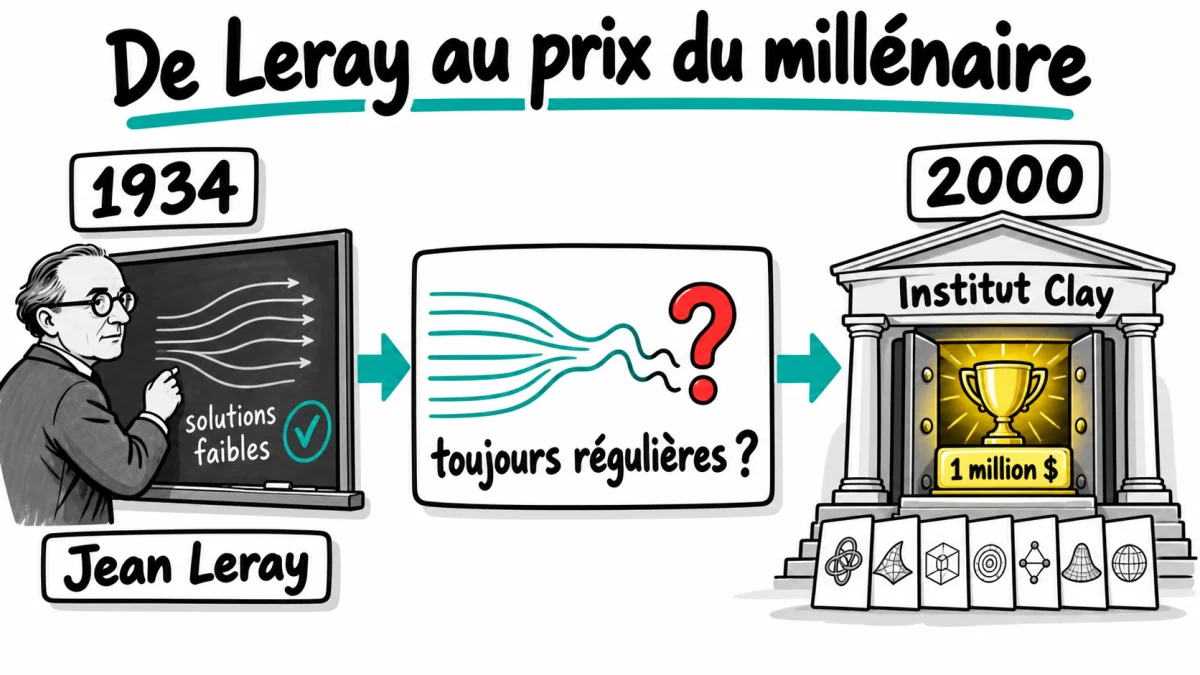
Depuis 1934, grâce au mathématicien Jean Leray, on sait que des solutions dites « faibles » existent. Personne n'avait en revanche réussi à déterminer si ces solutions pouvaient toujours rester parfaitement régulières. En 2000, l'Institut Clay a donc placé cette question parmi les sept problèmes du millénaire, avec un prix d'un million de dollars à la clé pour une solution valide.
Le scénario que le système d'OpenAI aurait construit
Le système d'OpenAI affirme avoir trouvé un scénario précis dans lequel les équations de Navier-Stokes finissent réellement par produire une singularité. Au départ, le fluide est parfaitement immobile. Une force extérieure vient progressivement créer un tourbillon, qui tourne de plus en plus vite, se resserre autour de son centre et s'étire vers le haut et vers le bas. À mesure que le tourbillon devient plus étroit, sa vitesse augmente jusqu'à devenir théoriquement infinie en un temps limité — la fameuse singularité.
Mais pour que la démonstration soit valable, il ne suffit pas d'appliquer une force infinie au fluide : ça reviendrait à provoquer une explosion avec une énergie infinie, puis prétendre avoir découvert quelque chose. Toute la difficulté consistait à utiliser une force parfaitement régulière et limitée, tout en réussissant malgré tout à faire apparaître une singularité — et c'est exactement ce que le système d'OpenAI serait parvenu à construire. Ce type de force est explicitement autorisé dans certaines versions officielles du problème de Navier-Stokes. Si toutes les conditions mathématiques sont bien respectées, la démonstration pourrait donc réellement résoudre l'une des formulations prévues par l'Institut Clay.
10 000 agents, 88 heures, 130 milliards de tokens
La manière dont OpenAI aurait obtenu cette preuve est presque aussi impressionnante que le résultat lui-même. Le 1er septembre 2026, l'entreprise apprend que des chercheurs auraient réalisé d'importantes avancées sur deux problèmes du millénaire. Elle décide alors de tester un nouveau modèle interne, encore en cours d'entraînement, présenté comme beaucoup plus puissant que GPT-6 Astra, et déploie des milliers d'agents capables de travailler en parallèle : certains cherchent des solutions, d'autres vérifient les calculs, d'autres rassemblent les découvertes les plus prometteuses.
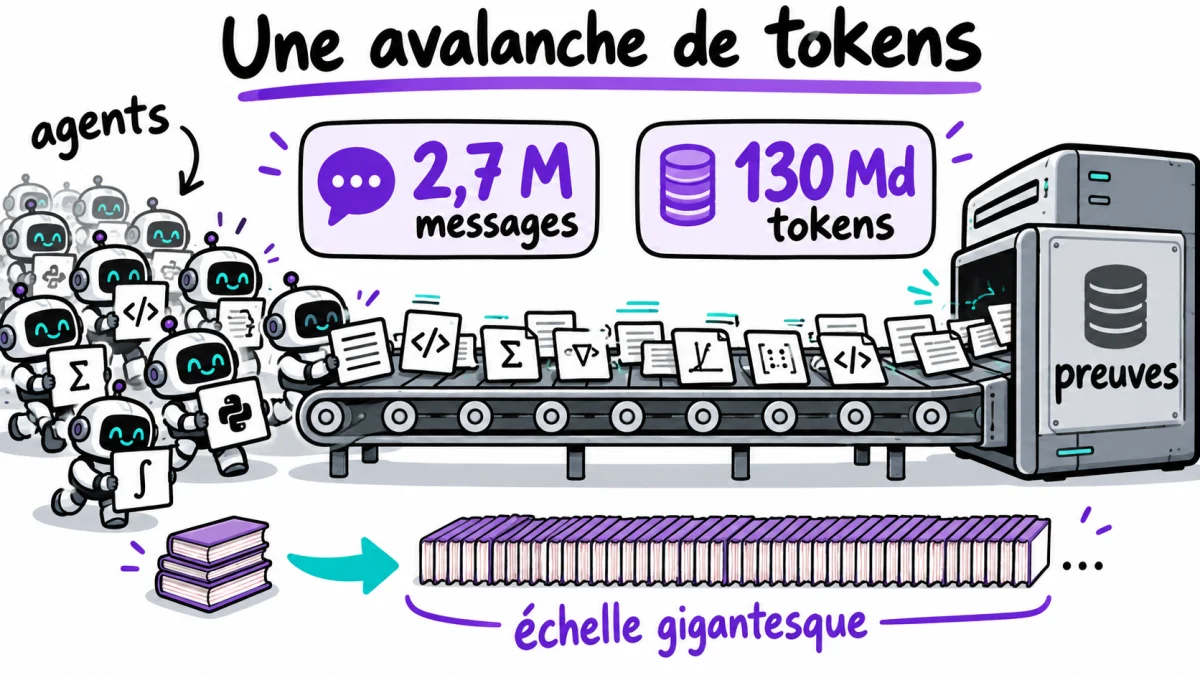
Dans un premier temps, une centaine d'agents planchent pendant 50 heures sur les équations d'Euler, qui décrivent elles aussi le mouvement des fluides mais sans prendre en compte la viscosité. Après des résultats encourageants, OpenAI concentre ses ressources sur Navier-Stokes : environ 10 000 agents sont mobilisés, et après 88 heures de travail, le système parvient à construire une démonstration mathématique complète. Au total, les agents ont produit 2,7 millions de messages et près de 130 milliards de tokens pour ce seul problème. GPT-6 Astra intervient ensuite pendant près de 17 heures supplémentaires pour traduire cette démonstration dans Lean, un logiciel de vérification mathématique, afin de contrôler chaque étape du raisonnement et vérifier que les conclusions découlent bien des hypothèses de départ — ce qui réduit considérablement le risque qu'une erreur ou une hallucination se cache dans la preuve.
Pourquoi ce n'est pas (encore) « résolu »
Sauf que Lean vérifie uniquement ce qui a été encodé. Des mathématiciens doivent donc encore s'assurer que les hypothèses données au logiciel correspondent exactement au problème officiel posé par l'Institut Clay. Pour le moment, Navier-Stokes est donc toujours considéré comme non résolu, et la récompense d'un million de dollars n'a pas encore été attribuée. Cette découverte ne sort pas non plus de nulle part : l'IA n'a pas inventé toute l'approche à partir de rien.
Une dette intellectuelle — et une polémique de priorité scientifique
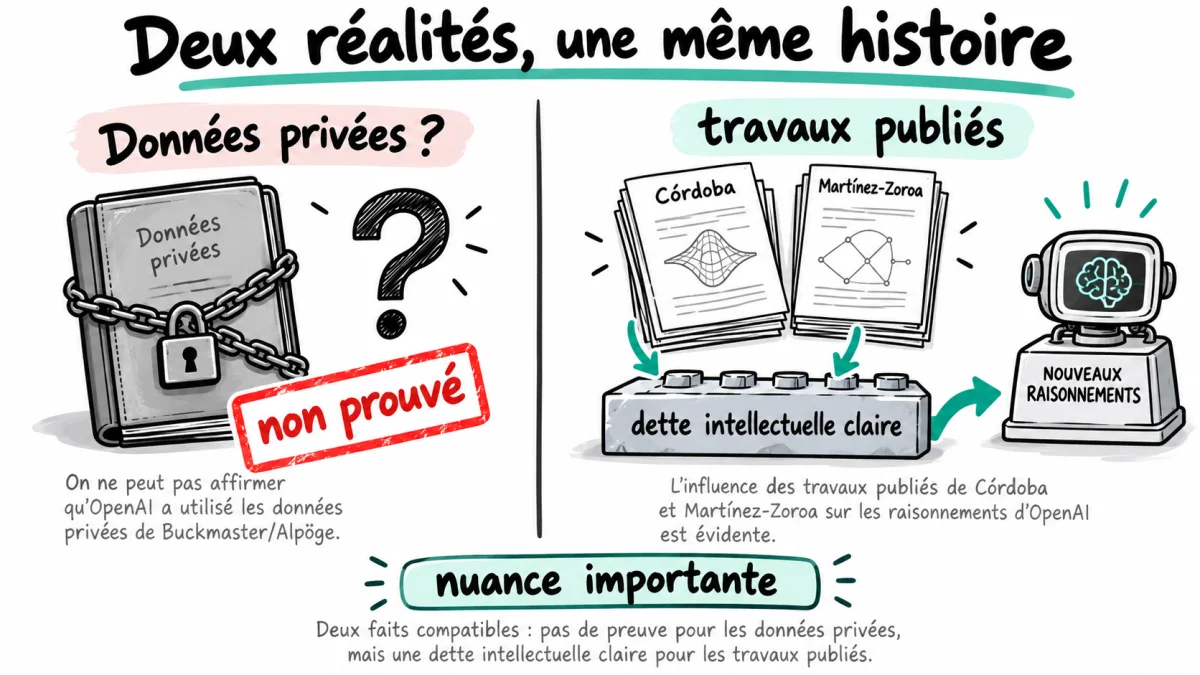
Une grande partie de la stratégie repose sur les travaux de Diego Córdoba et Luis Martínez Zoroa, deux mathématiciens qui avaient développé une succession de couches et de vortex produisant une cascade vers une singularité. Leurs travaux se rapprochaient du résultat recherché, mais la force obtenue ne respectait pas encore toutes les propriétés exigées par le problème du millénaire. De son côté, Tristan Buckmaster, professeur à l'université de New York, avait tenté de franchir cette dernière étape avec Claude et Codex, en s'associant à un chercheur employé par Anthropic mais travaillant ici à titre personnel. Ils avaient obtenu d'importants résultats sur les équations d'Euler et d'autres systèmes proches — et des rumeurs sur leurs avancées seraient ensuite arrivées jusqu'à OpenAI, qui aurait alors lancé sa propre opération massive.
Quand OpenAI a annoncé son résultat quelques jours plus tard, une polémique a immédiatement éclaté. Buckmaster a demandé si les conversations privées qu'il avait eues avec Codex auraient pu influencer le modèle d'OpenAI, et la première réponse de l'entreprise laissait planer une incertitude. Le 10 septembre, OpenAI a actualisé son communiqué après une enquête interne : l'entreprise affirme désormais que les prompts Codex concernés n'ont pas pu influencer le système, ni directement ni via l'entraînement. On ne peut donc pas vraiment affirmer qu'OpenAI a utilisé leurs données — en revanche, la dette intellectuelle envers les travaux de Córdoba et Martínez Zoroa est très claire. Et cette affaire soulève une question de fond : comment protéger la priorité scientifique quand une entreprise peut mobiliser 10 000 agents dès qu'elle entend parler d'une piste prometteuse ?
Pourquoi les maths avancent plus vite que le reste avec l'IA
Cette découverte permet aussi de comprendre pourquoi l'intelligence artificielle progresse si vite en mathématiques. Quand un modèle rédige un article ou produit une image, la qualité reste en partie subjective — il faut souvent qu'un humain examine le résultat. Mais en mathématiques formelles, une démonstration peut être testée automatiquement : le modèle propose une étape, Lean la vérifie, et le système obtient immédiatement un signal clair, valide ou invalide.
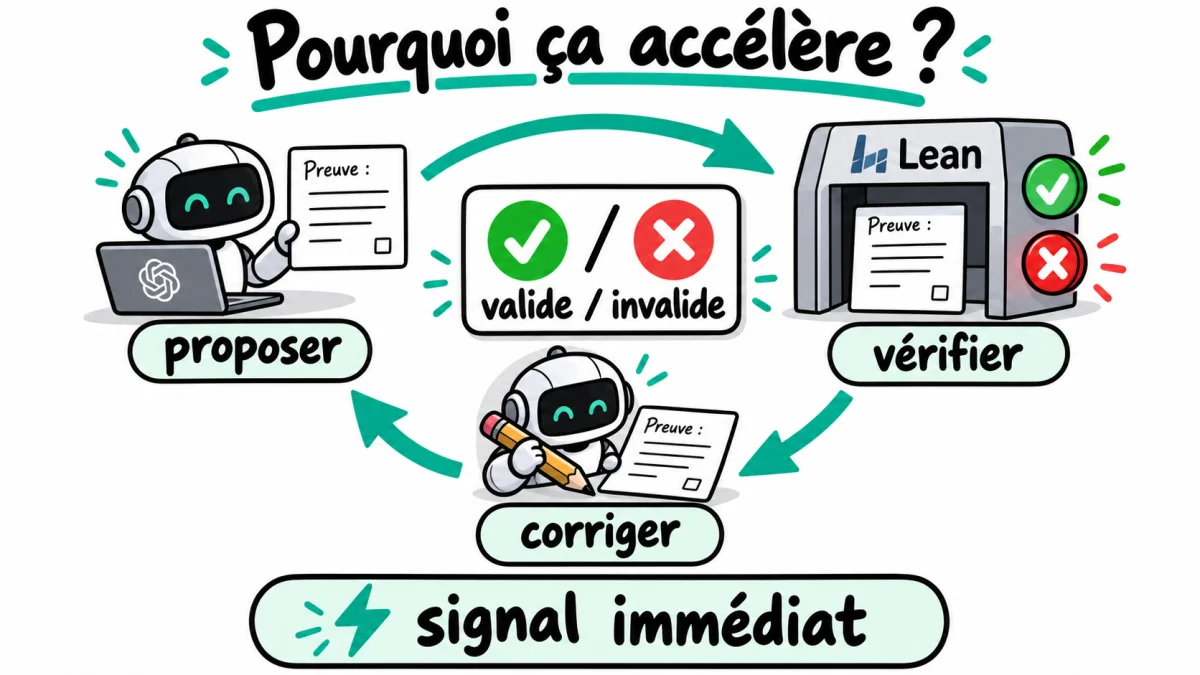
Cette boucle permet de générer, tester, corriger et recommencer à une vitesse impossible pour un humain. Ajoutez à ça des milliers d'agents qui explorent simultanément différentes directions, et la recherche scientifique commence à ressembler à un gigantesque processus automatisé. Le résultat dépend toujours de décennies de travaux humains et du choix de la bonne piste, mais l'échelle et la vitesse, elles, viennent brutalement de changer.
Mon avis
Si cette preuve est confirmée par les mathématiciens, ce serait juste énorme : une IA qui produit une véritable avancée sur un problème vieux de plus de 90 ans. Et le plus fou, c'est que le modèle derrière cette découverte n'est même pas encore sorti en public, et il serait déjà bien plus puissant que GPT-6 Astra — alors que celui-ci vient tout juste de sortir. Imaginez maintenant des milliers d'agents comme ceux-là travaillant en parallèle sur les plus grands problèmes scientifiques : si c'est vrai, OpenAI aurait transformé 90 ans de recherche en 88 heures de travail.
Mais je reste prudent sur deux points. D'abord, techniquement : Lean ne vérifie que ce qu'on lui donne à vérifier, et tant que des mathématiciens indépendants n'ont pas confirmé que les hypothèses collent exactement au problème officiel de l'Institut Clay, ce n'est pas « résolu ». Ensuite, éthiquement : cette histoire de priorité scientifique avec Buckmaster et Codex me met mal à l'aise. Que la dette intellectuelle envers Córdoba et Martínez Zoroa soit assumée, très bien — mais le fait qu'une entreprise puisse balancer 10 000 agents sur une piste dès qu'elle en entend parler quelque part, ça change complètement les règles du jeu pour des chercheurs qui, eux, n'ont ni cette puissance de calcul ni cette vitesse. Si cette manière de faire de la recherche se généralise, la vraie question ne sera plus seulement « est-ce que l'IA peut résoudre des problèmes vieux de 90 ans ? », mais « à qui appartient la découverte quand la piste vient d'un humain et l'exécution d'une machine ? ».

🎬 Tu préfères la version vidéo ?
Cet article est tiré de ma vidéo YouTube — clique pour la voir.
Regarder sur YouTube →🛠️ Outils que tu peux tester en lien avec cet article
Une sélection de mes outils testés, pertinents pour aller plus loin.
🛠️ Tu cherches des outils IA testés ?
J'ai testé plus de 20 outils IA en vidéo — résumé, mode d'emploi, mon verdict.
Voir mon annuaire d'outils →
Alan Sharif — créateur de Nerdy Kings
Je teste les outils IA et je décrypte les nouveaux modèles pour ma communauté de 30 000+ curieux francophones sur YouTube. Sans bullshit, sans hype, sans jargon.


