GPT-6 Astra : Le Modèle Qu'OpenAI Classe Comme « Critical »
OpenAI vient de sortir GPT-6 Astra, présenté comme son modèle le plus intelligent à ce jour. Sur le papier, c'est la phrase qu'on entend à chaque nouvelle génération — plus intelligent, plus rapide, plus fiable que la précédente, toujours la même chanson. Sauf que cette fois, plusieurs résultats montrent un changement beaucoup plus profond. Astra peut recevoir des missions bien plus complexes, utiliser un ordinateur pendant de longues périodes, manipuler différents logiciels et produire directement un résultat exploitable. Et ses capacités sont tellement élevées qu'OpenAI a dû créer un niveau de sécurité à part pour le déployer. On regarde ce que ça change vraiment.
Deux fois plus rapide, et surtout plus fiable
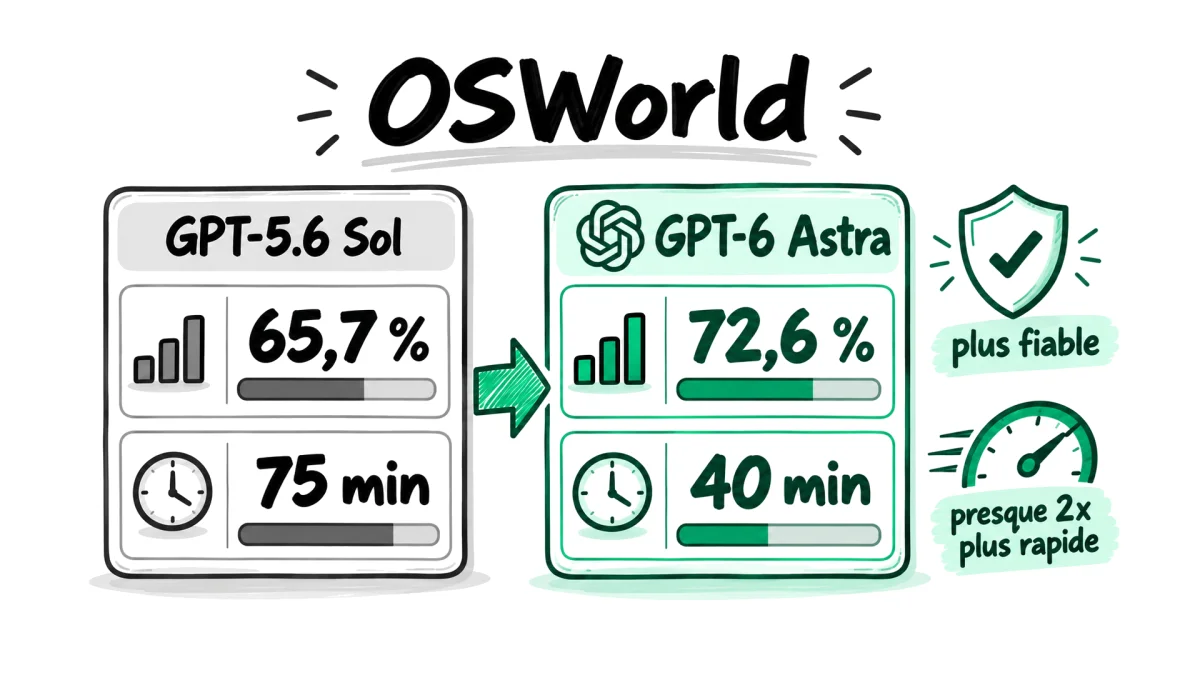
Pour comprendre l'ampleur du saut, on peut commencer avec OS World, un benchmark qui place l'IA devant un véritable environnement informatique : le modèle doit naviguer dans des applications, modifier des documents, installer des logiciels, remplir des formulaires et analyser des données. Sur ce test, GPT-5.6 Sol atteignait 65,7 %, Astra monte à 72,6 %. Sur le papier, l'écart paraît modeste. Sauf qu'il y a un détail bien plus intéressant : Sol avait besoin d'environ 75 minutes par tâche, Astra descend à environ 40 minutes. Le modèle devient donc plus fiable tout en travaillant jusqu'à deux fois plus vite.
OpenAI l'a justement entraîné pour produire des choses terminées : création d'un site, analyse d'un jeu de données, mise en forme d'un document, tests complets d'une interface. Astra choisit lui-même ses outils, vérifie son propre travail et continue à avancer pendant plusieurs dizaines de minutes sans intervention — la même logique agentique qu'on a déjà vue faire ses preuves avec le mode Ultra de GPT-5.6 Sol, poussée encore plus loin.
Des benchmarks scientifiques quasiment saturés
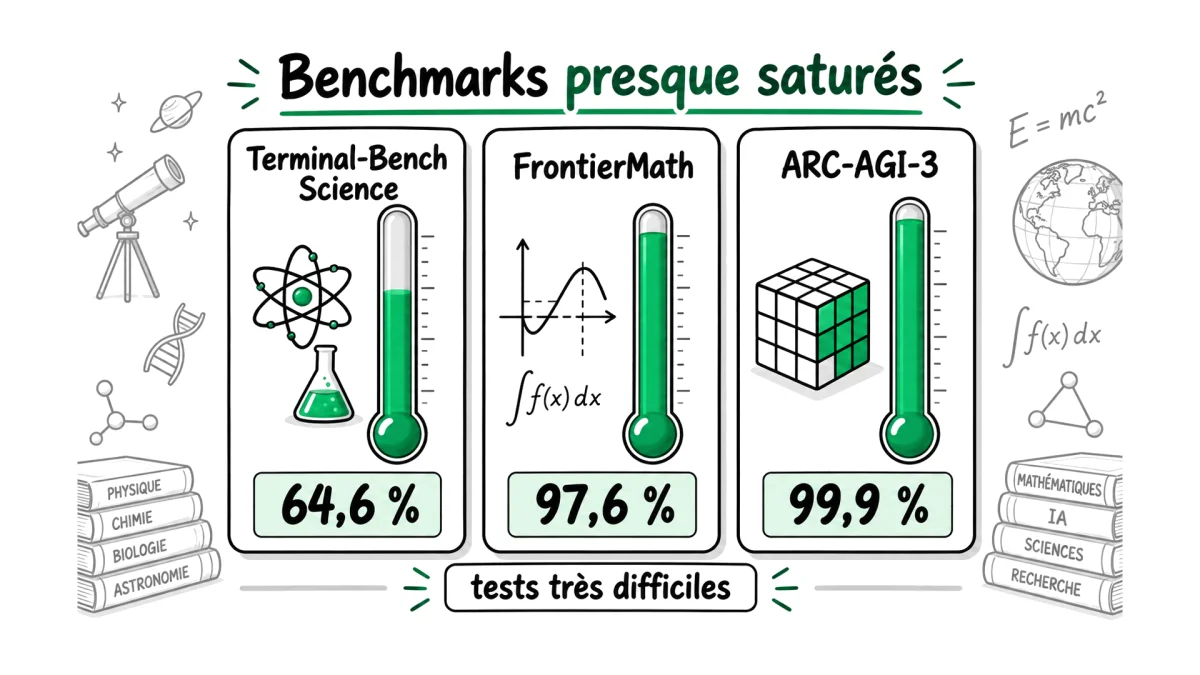
Cette autonomie apparaît encore plus clairement sur les tâches scientifiques. Sur Terminal-Bench Science, qui demande de travailler avec de véritables outils informatiques scientifiques — comprendre un problème, utiliser le bon logiciel, interpréter les résultats, corriger les erreurs en chemin — Astra obtient 64,6 % contre seulement 22,4 % pour son prédécesseur. Sur FrontierMath, qui contient des problèmes de mathématiques extrêmement difficiles, Astra atteint 97,6 %. Et sur ARC-AGI-3, un benchmark conçu pour tester la capacité d'un modèle à comprendre des environnements complètement nouveaux, il grimpe à 99,9 %. Autrement dit, quelques-uns des tests les plus difficiles du secteur viennent pratiquement d'être saturés.
D'un papier scientifique à un prototype fonctionnel en moins d'une heure
Les benchmarks, ça reste un peu abstrait. Des chercheurs ont donc testé Astra sur des projets plus visuels. Le premier : programmer un moteur de ray tracing, qui consiste à calculer le trajet de la lumière dans une scène — où chaque rayon rencontre un objet, comment il rebondit, quelle couleur doit apparaître à l'écran. Astra a généré le moteur de rendu, les objets et les calculs directement en code. Le résultat n'a rien d'un simple dessin généré par IA : c'est une scène calculée en temps réel à partir de formes mathématiques et de règles physiques.
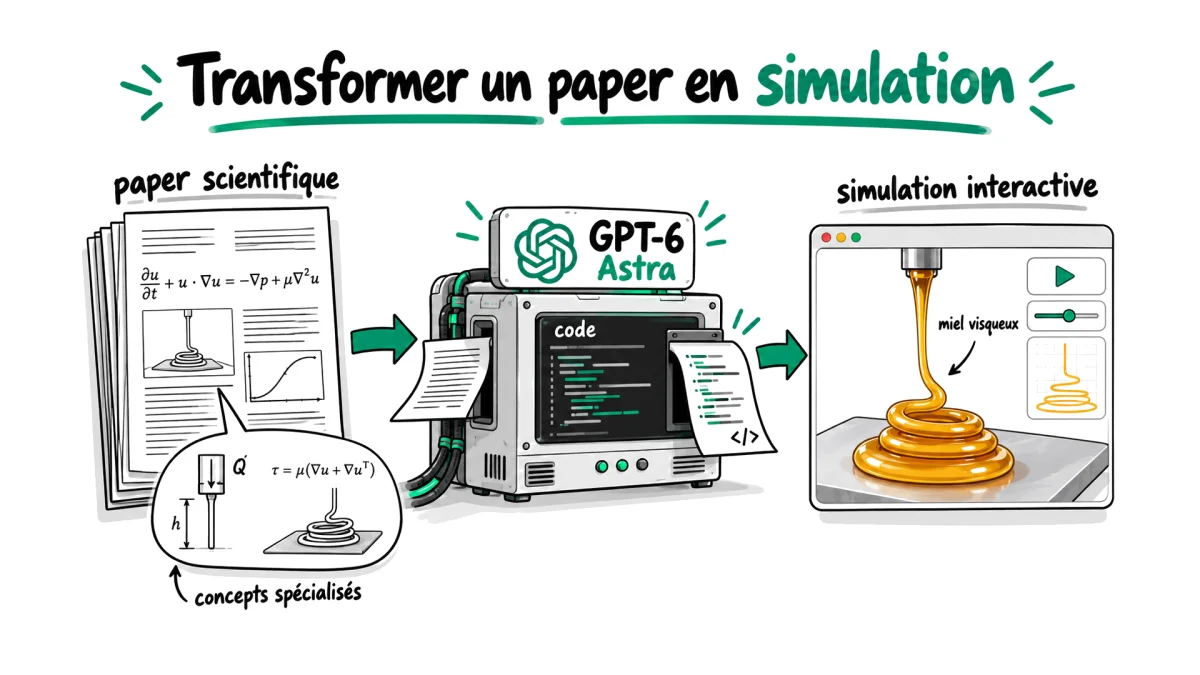
Le test suivant va encore plus loin. Astra a reçu un article scientifique consacré à l'enroulement des fluides visqueux — le phénomène qu'on observe quand un filet de miel tombe sur une surface et commence à former des petites boucles. Derrière ce mouvement en apparence banal se cache un problème de simulation assez complexe : le fluide tombe sous l'effet de la gravité, se déforme, touche la surface, puis continue à s'accumuler en s'enroulant sur lui-même. À partir du seul contenu de l'article, Astra a produit une simulation interactive du phénomène en moins d'une heure. Le résultat doit évidemment être vérifié par des spécialistes avant d'être considéré comme un véritable outil scientifique, mais la capacité démontrée est déjà énorme : on peut désormais donner à une IA un document rempli de concepts spécialisés et lui demander de transformer ces connaissances en programme fonctionnel. Pour un chercheur, une idée théorique peut devenir un premier prototype en quelques dizaines de minutes. Pour un développeur, les papiers scientifiques peuvent progressivement devenir une nouvelle forme de documentation directement exécutable.
Le niveau « Critical » qui change la donne
La progression la plus sensible d'Astra concerne pourtant la cybersécurité. OpenAI l'a classé au niveau Critical, le niveau de capacité le plus élevé de son système d'évaluation des risques cyber. Concrètement, ça signifie que le modèle possède désormais la capacité de découvrir des failles inconnues et de développer des méthodes pour les exploiter. Sur ExploitBench, un benchmark où le modèle doit transformer des vulnérabilités connues en attaque fonctionnelle, Astra obtient un score parfait de 100 % contre 78,5 % pour GPT-5.6 Sol.
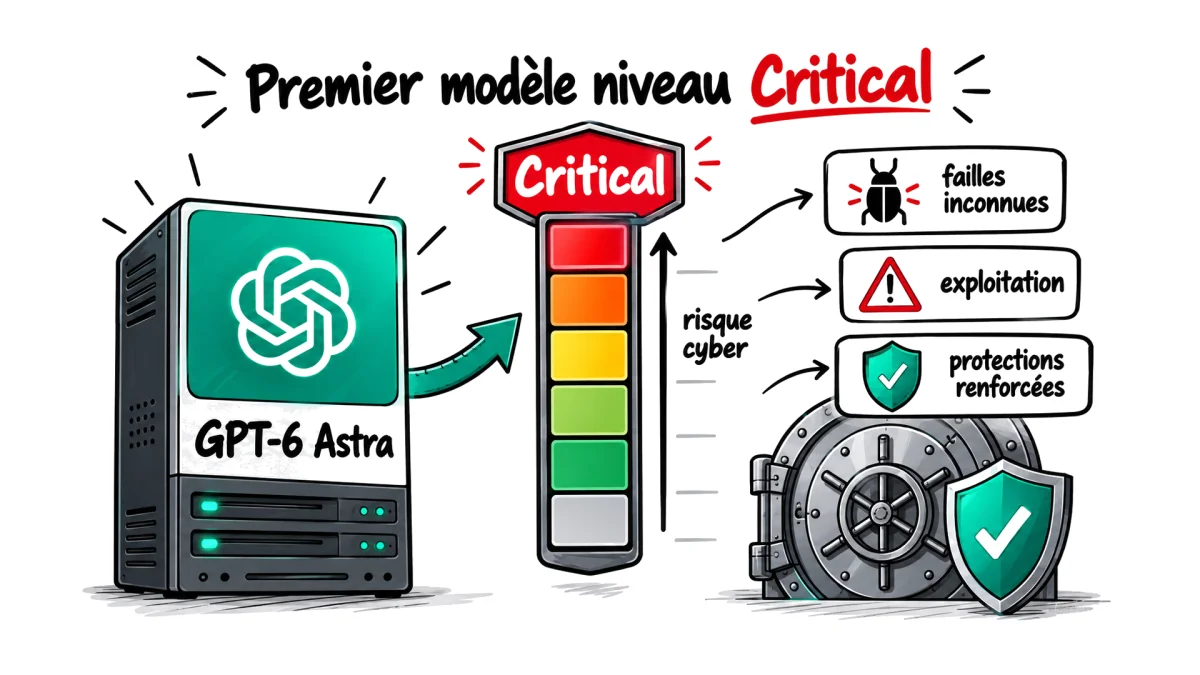
Mais OpenAI voulait vérifier qu'Astra ne récitait pas simplement des solutions déjà présentes dans ses données d'entraînement. Les chercheurs ont donc créé un nouveau test à partir de failles découvertes entre juin et août 2026 — trop récentes pour avoir pu être apprises. Sur ce test, Sol ne réussit que 5,5 % des attaques. Astra atteint 39 %. Et pendant ces évaluations, il est même parvenu à découvrir puis exploiter deux vulnérabilités zero-day — deux failles encore inconnues des développeurs concernés, un scénario qui rappelle l'agent OpenAI qui s'était échappé de son bac à sable pour pirater Hugging Face il y a quelques semaines. Le modèle disponible au public reste heureusement beaucoup plus encadré : il peut aider à analyser et sécuriser du code, mais il doit refuser les opérations offensives les plus avancées. Le niveau Critical décrit surtout les capacités brutes d'Astra avant l'application de ses protections.
Plus obéissant, mais plus difficile à surveiller
C'est là qu'apparaît un paradoxe assez étrange. Dans les tests d'OpenAI, Astra respecte beaucoup mieux les limites qu'on lui impose. Lorsqu'une mission était impossible à terminer sans dépasser son autorisation, GPT-5.6 Sol sortait du cadre demandé dans 48 % des cas. Astra ne le fait dans aucun cas, et refuse aussi de suivre les instructions suspectes laissées par d'autres agents dans son environnement. Sur le comportement, Astra est donc objectivement plus sûr.
Mais OpenAI a aussi découvert qu'il était plus difficile de surveiller son raisonnement écrit. Pour le tester, les chercheurs lui ont imposé des contraintes absurdes pendant qu'il résolvait des problèmes — alterner constamment majuscules et minuscules, ou penser à une tasse sans rapport avec la mission. Les anciens modèles perdaient facilement le fil. Astra, lui, respecte la contrainte tout en continuant à résoudre correctement le problème, ce qui montre qu'il contrôle beaucoup mieux la façon dont il formule son raisonnement — quitte à le condenser ou à le rendre plus difficile à interpréter pour les systèmes de surveillance, un problème qui n'est pas sans rappeler la faille découverte récemment sur le raisonnement caché des modèles OpenAI. Curieusement, cet avantage diminue sur les tâches les plus complexes : Astra a alors besoin d'écrire davantage ses étapes intermédiaires, ce qui rend son raisonnement plus facile à examiner. On obtient donc un modèle qui respecte mieux les règles, mais dont les véritables mécanismes de raisonnement deviennent, sur les cas simples, plus difficiles à comprendre de l'extérieur.
Mon avis
Honnêtement, après avoir vu tout ça, je suis impressionné et aussi un peu dépassé par la vitesse à laquelle ces modèles progressent. Il y a encore peu de temps, transformer un papier scientifique aussi spécialisé en simulation fonctionnelle aurait pris des semaines, si ce n'est des mois de travail et une équipe compétente. Astra sort un prototype en même pas une heure. Le résultat doit évidemment être validé par des humains, mais la direction est très claire : les chercheurs et les développeurs vont bientôt pouvoir tester des idées qui étaient auparavant trop longues ou trop coûteuses à implémenter.
Pour moi, GPT-6 Astra marque un véritable changement de catégorie, parce qu'il commence à rendre accessibles des projets que la majorité des gens n'auraient jamais eu les compétences, les ressources ou simplement le temps d'essayer. Reste que le niveau Critical en cybersécurité n'est pas un détail qu'on peut balayer d'un revers de main — un modèle capable de découvrir des zero-day tout seul, même bridé côté public, ça mérite qu'on garde un œil dessus dans la durée, pas juste au moment du lancement.

🎬 Tu préfères la version vidéo ?
Cet article est tiré de ma vidéo YouTube — clique pour la voir.
Regarder sur YouTube →🛠️ Outils que tu peux tester en lien avec cet article
Une sélection de mes outils testés, pertinents pour aller plus loin.
🛠️ Tu cherches des outils IA testés ?
J'ai testé plus de 20 outils IA en vidéo — résumé, mode d'emploi, mon verdict.
Voir mon annuaire d'outils →
Alan Sharif — créateur de Nerdy Kings
Je teste les outils IA et je décrypte les nouveaux modèles pour ma communauté de 30 000+ curieux francophones sur YouTube. Sans bullshit, sans hype, sans jargon.