GPT-6 vs Claude Opus 5.5 : Le Vrai Coût Se Joue Sur Les Tokens
Depuis quelque temps, il se passe quelque chose d'assez fou avec les nouveaux modèles d'intelligence artificielle : ils deviennent meilleurs, mais aussi beaucoup moins chers. La compétition entre OpenAI, Anthropic, Google, DeepSeek ou les laboratoires chinois pousse constamment les prix vers le bas — on l'a encore vu récemment avec Claude Opus 5.5, dont Anthropic a réduit plusieurs tarifs. Intuitivement, on pourrait croire que c'est une excellente nouvelle : les modèles deviennent plus intelligents pendant que le prix de cette intelligence baisse. Sauf qu'il manque une variable dont on parle étonnamment peu : combien de tokens le modèle doit consommer pour résoudre votre problème. Et sur ce point, GPT-6 et Claude Opus 5.5 racontent deux histoires complètement différentes.
Le prix à l'heure ne suffit pas — l'analogie qui change tout
Imaginez deux employés. Le premier coûte 10 € de l'heure, le second 20 €. Si je vous demande lequel est le moins cher, vous allez instinctivement répondre le premier. Sauf que maintenant, je leur donne exactement le même travail : le premier met 10 heures à le terminer, le second seulement 3. Le premier m'a donc coûté 100 €, le second 60 €. Celui qui me coûtait deux fois plus cher à l'heure était finalement le moins cher pour accomplir le travail.
Avec les modèles d'IA, on peut avoir exactement le même problème. On compare constamment les modèles sur leur prix pour 1 million de tokens, mais ce prix ne dit pas combien de tokens le modèle va consommer pour arriver au résultat.
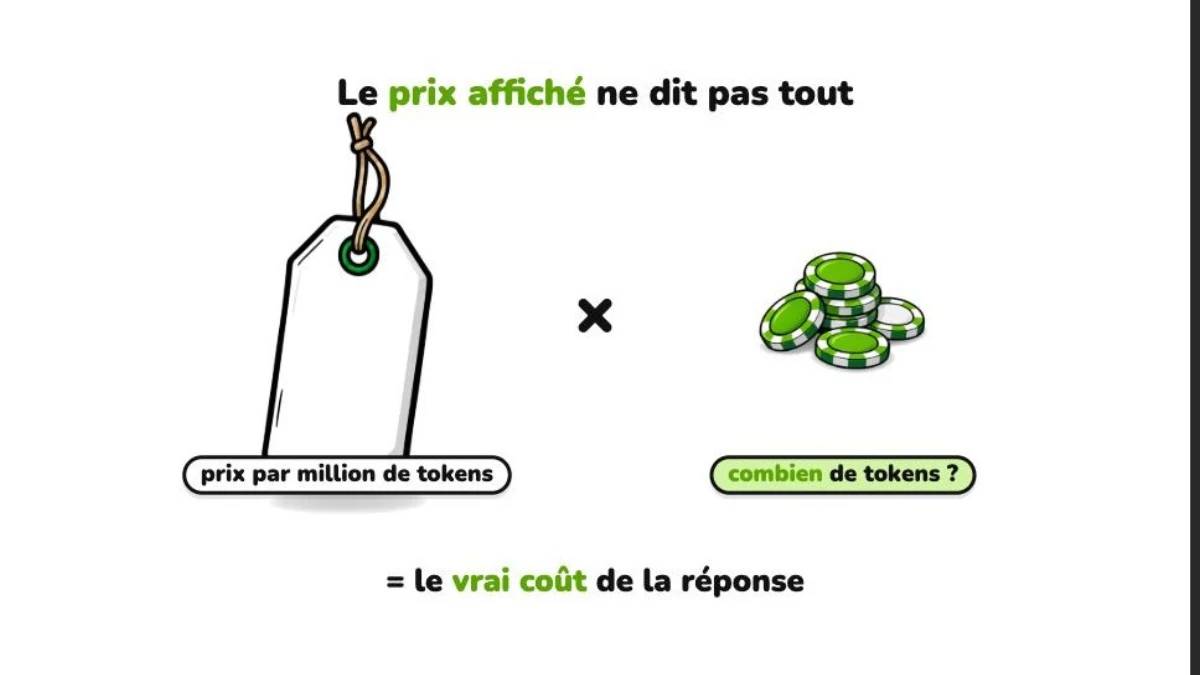
Le prix affiché ne dit pas tout
Avec Opus 5.5, Anthropic a effectivement rendu son modèle beaucoup plus intéressant économiquement en baissant le prix de ses tokens en entrée comme en sortie. Sur le papier, c'est excellent. Mais lorsqu'on regarde ce qui se passe pendant le raisonnement, on découvre quelque chose d'intéressant : le vrai coût d'une réponse, ce n'est pas seulement le prix par million de tokens, c'est ce prix multiplié par le nombre de tokens réellement consommés.
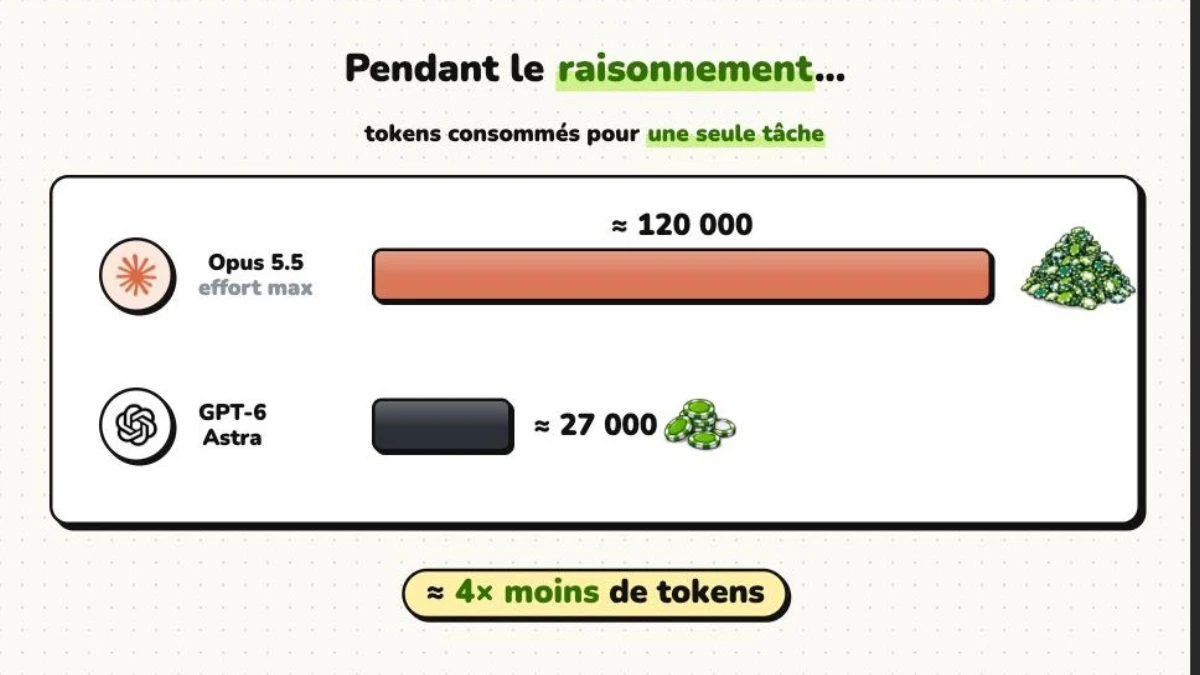
GPT-6 Astra consomme jusqu'à 4 fois moins de tokens
Pour accomplir une tâche donnée en raisonnement, Claude Opus 5.5 en mode effort maximal consomme environ 120 000 tokens. GPT-6 Astra, lui, tourne autour de 27 000 tokens — potentiellement plus de 4 fois moins. Bien sûr, les réglages comptent et les tâches sont différentes : Anthropic précise d'ailleurs qu'avec ses paramètres par défaut, Opus 5.5 consomme moins qu'Opus 5. Mais comparer uniquement le prix des tokens ne suffit clairement plus.
Habituellement, pour comparer des modèles, on regarde deux choses : l'intelligence et le coût. On peut tracer une frontière de Pareto entre les modèles les plus performants et les moins chers — plus un modèle devient intelligent sans faire exploser son prix, plus il est intéressant. Mais en ajoutant une troisième variable, le nombre de tokens consommés, le graphique en deux dimensions devient un graphique en trois dimensions : intelligence, coût, et tokens nécessaires pour produire cette intelligence. GPT-6 est particulièrement intéressant sur ce plan : il augmente sa performance tout en maintenant une consommation relativement contenue. Opus 5.5 suit une trajectoire différente — il peut pousser l'intelligence plus loin sur certaines évaluations, mais dès qu'on augmente fortement son effort de raisonnement, sa consommation de tokens grimpe beaucoup plus vite.
Ce que disent les benchmarks
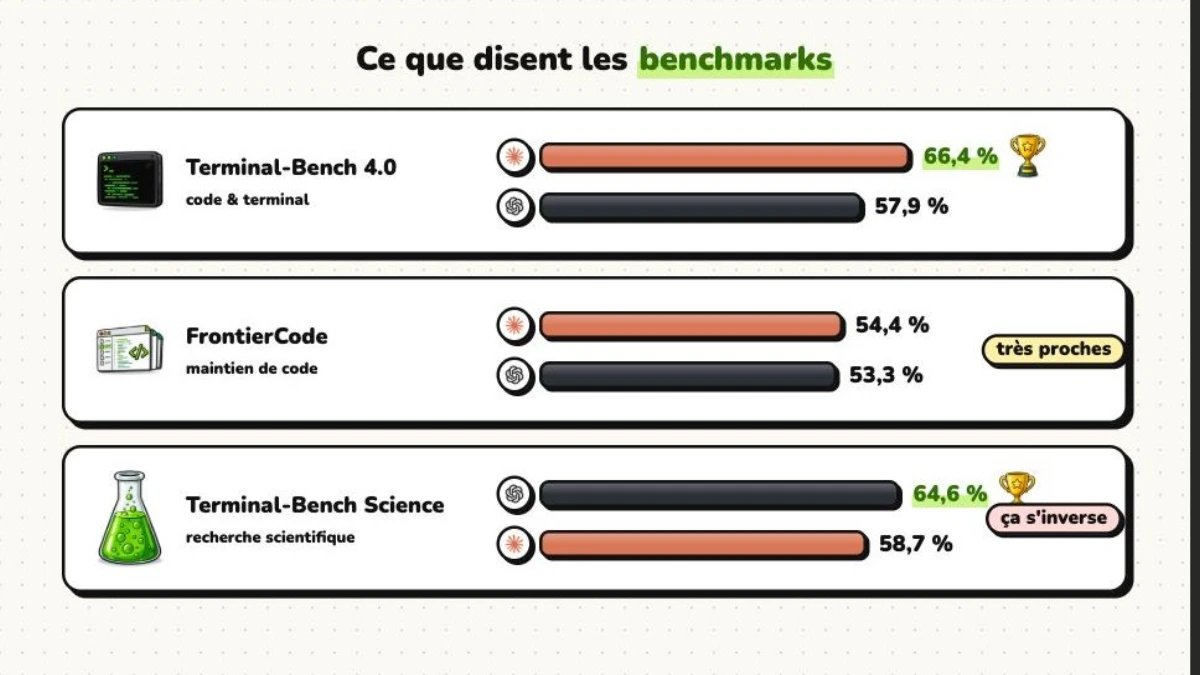
Les benchmarks montrent d'ailleurs pourquoi on ne peut pas simplement déclarer qu'un modèle est meilleur que l'autre. Sur Terminal-Bench 4.0, Opus 5.5 obtient 66,4 % contre 57,9 % pour GPT-6 Astra. Sur FrontierCode, les deux sont beaucoup plus proches : 54,4 % pour Opus 5.5 contre 53,3 % pour GPT-6 Astra. Et sur Terminal-Bench Science, la situation s'inverse : GPT-6 Astra atteint 64,6 % contre 58,7 % pour Opus 5.5. On n'a donc pas un modèle qui serait efficace et un autre pas du tout — on a plutôt deux manières différentes de transformer du calcul en intelligence.
API ou abonnement : deux situations très différentes
Ça devient extrêmement important avec l'arrivée des agents IA. Si Claude vous donne une réponse excellente, vous vous fichez probablement qu'il ait utilisé 5 000 ou 50 000 tokens pour la produire. Sauf que quelqu'un doit payer pour ces tokens, et il existe deux situations très différentes.
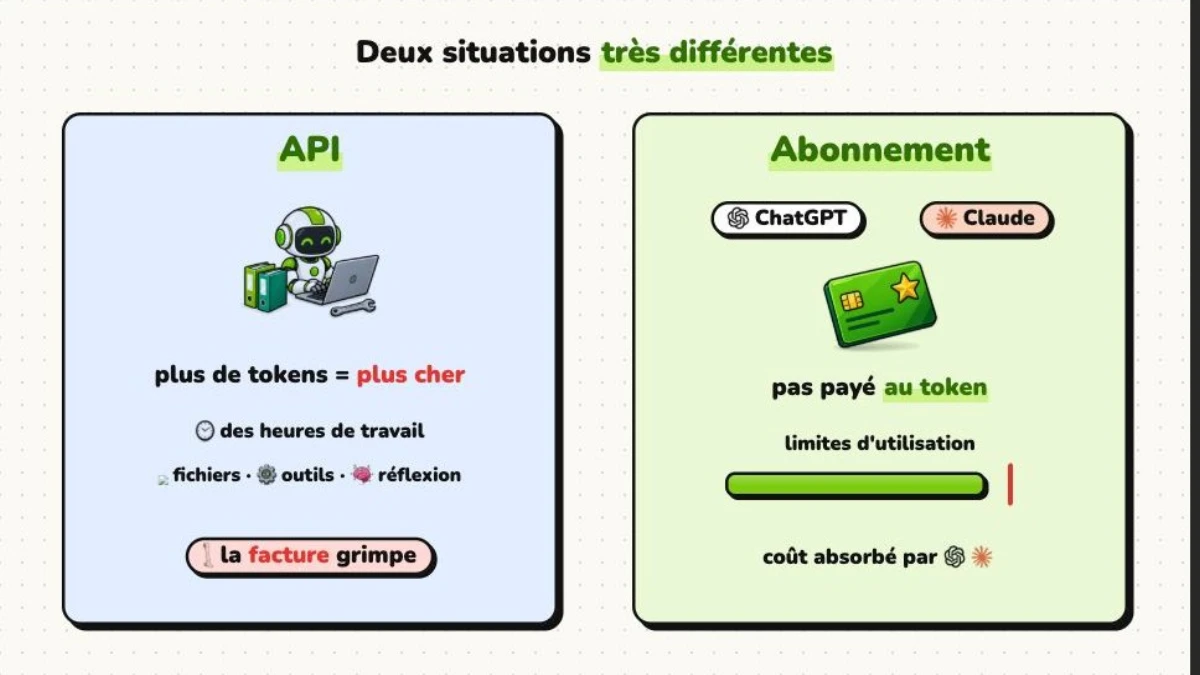
Avec une API, c'est simple : plus votre agent consomme de tokens, plus vous payez. Si vous construisez un agent qui travaille pendant plusieurs heures, explore des fichiers, utilise des outils ou réfléchit énormément, l'efficacité en tokens affecte directement votre facture. Avec un abonnement comme ChatGPT ou Claude, la situation est complètement différente : vous ne payez pas chaque token individuellement, le fournisseur vous donne accès au modèle avec certaines limites d'utilisation. Une partie du coût de cette consommation est donc absorbée par OpenAI, Anthropic ou les autres — d'où les fenêtres d'utilisation, les quotas et les différents niveaux d'effort selon les produits. Le fournisseur doit constamment arbitrer entre la puissance qu'il donne, le calcul consommé, et ce qu'on lui paie.
Mon avis
Ce qu'il faut retenir, c'est que oui, le prix de l'intelligence artificielle est en train de chuter — mais regarder uniquement le prix d'un million de tokens ne suffit plus. Un modèle peut être moins cher à l'affichage tout en ayant besoin de beaucoup plus de tokens pour arriver au même résultat. À l'inverse, un modèle plus cher au token peut être plus rentable s'il arrive au résultat plus vite, avec moins de tokens.
Pendant longtemps, la seule question qui comptait, c'était « quel est le modèle le plus intelligent ? ». Avec DeepSeek et l'arrivée massive des modèles chinois, une deuxième question s'est imposée : « combien coûte cette intelligence ? ». Aujourd'hui, il faut aller encore plus loin : « combien de ressources faut-il pour la produire ? ». Et avec la multiplication des agents IA qui tournent des heures sur des tâches complexes, cette troisième question va probablement peser de plus en plus lourd dans le choix du modèle — bien plus que le prix affiché sur la page tarifs.

🎬 Tu préfères la version vidéo ?
Cet article est tiré de ma vidéo YouTube — clique pour la voir.
Regarder sur YouTube →🛠️ Outils que tu peux tester en lien avec cet article
Une sélection de mes outils testés, pertinents pour aller plus loin.
🛠️ Tu cherches des outils IA testés ?
J'ai testé plus de 20 outils IA en vidéo — résumé, mode d'emploi, mon verdict.
Voir mon annuaire d'outils →
Alan Sharif — créateur de Nerdy Kings
Je teste les outils IA et je décrypte les nouveaux modèles pour ma communauté de 30 000+ curieux francophones sur YouTube. Sans bullshit, sans hype, sans jargon.