FP4 : Comment NVIDIA Entraîne Les IA En Seulement 4 Bits (NVFP4)
NVIDIA est peut-être en train de complètement changer la façon dont on entraîne les IA. Et l'idée derrière est presque paradoxale : utiliser des nombres beaucoup plus petits pour obtenir beaucoup plus de puissance. Ça s'appelle le NVFP4, la version NVIDIA du format FP4, qui permet d'entraîner des modèles avec seulement 4 bits par nombre au lieu de 32, 16 ou 8. Sur le papier, c'est extrêmement intéressant : moins de mémoire, plus de calculs en parallèle sur les GPU. Le problème, c'est que plus on réduit la taille des nombres, plus on perd en précision — et à 4 bits, ça devient très compliqué. Voici comment NVIDIA s'y prend, et ce que ça change pour la suite.
De 32 bits à 4 bits : pourquoi NVIDIA veut des nombres plus petits
Quand un modèle d'intelligence artificielle est entraîné, il manipule en permanence des milliards de nombres. Ces nombres prennent de la place : ils doivent être stockés dans la mémoire des GPU, déplacés, puis utilisés pour effectuer énormément de calculs. Pendant longtemps, ils étaient représentés avec 32 bits, puis on est passé à 16 bits, puis à 8. Maintenant, NVIDIA veut descendre jusqu'à 4 bits avec le NVFP4. La logique est simple : plus les nombres sont petits, moins ils prennent de place, et plus les GPU peuvent en traiter en même temps.
Pourquoi l'entraînement en 4 bits est aussi compliqué
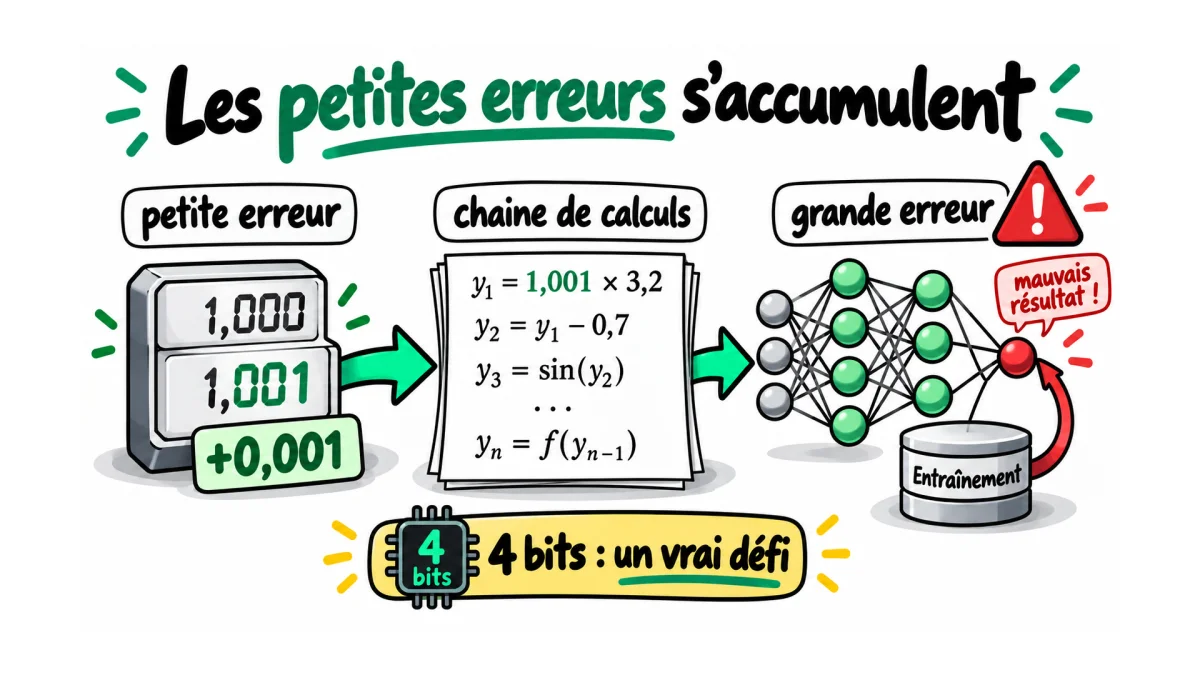
Imaginez que je vous demande de mesurer quelque chose avec une règle extrêmement précise : vous pouvez me répondre 12,37 cm. Avec une règle beaucoup moins précise, vous direz peut-être simplement 12 cm. Vous utilisez moins d'information, mais vous perdez aussi en précision. Pour une mesure isolée, ce n'est pas forcément dramatique. Mais pour une IA qui effectue des milliards et des milliards de calculs pendant son entraînement, ces petites erreurs s'accumulent, et le modèle peut finir par mal apprendre. C'est pour ça que descendre à 4 bits est beaucoup plus difficile qu'il n'y paraît.
NVFP4 : regrouper les nombres pour ne pas perdre l'essentiel
NVIDIA ne s'est pas contenté de couper brutalement les nombres en 4 bits : l'entreprise a développé plusieurs techniques pour conserver les informations importantes. L'idée principale consiste à regrouper les nombres qui se ressemblent. Imaginez une dizaine de valeurs tout autour de 0,1 : plutôt que de représenter parfaitement chacune d'elles, on les regroupe et on leur donne une sorte de repère commun. Le NVFP4 utilise de petits groupes de seulement 16 valeurs. Pas besoin de retenir exactement comment ça fonctionne : l'important, c'est que NVIDIA essaie de compresser énormément les nombres sans jeter les informations essentielles — un peu comme une image compressée qui devient beaucoup plus légère alors qu'à l'œil nu, elle reste presque identique.
Pas tout en 4 bits : la recette à 85 %
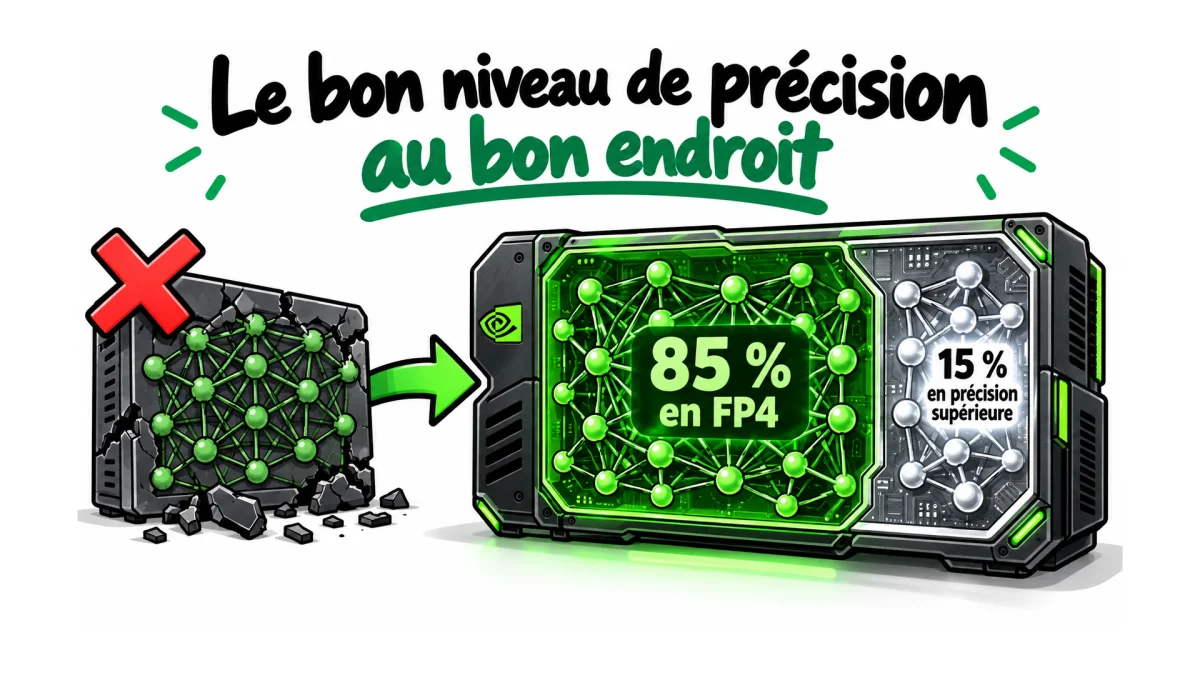
Il y a un détail important : NVIDIA ne cherche pas à faire tourner 100 % de l'entraînement en 4 bits, parce que certaines parties d'un modèle sont beaucoup plus sensibles que d'autres. Dans les expériences présentées par NVIDIA, quand tout est passé en FP4, l'entraînement peut tout simplement échouer. La solution : utiliser le 4 bits là où ça fonctionne bien, et conserver davantage de précision là où elle est vraiment nécessaire. Dans l'une de leurs recettes expérimentales, environ 85 % du réseau peut profiter du FP4, tandis que les parties les plus sensibles restent dans une précision supérieure. NVIDIA ne met donc pas tout en 4 bits : elle cherche le meilleur compromis possible.
Blackwell, GB200, Vera Rubin : des GPU pensés pour le FP4
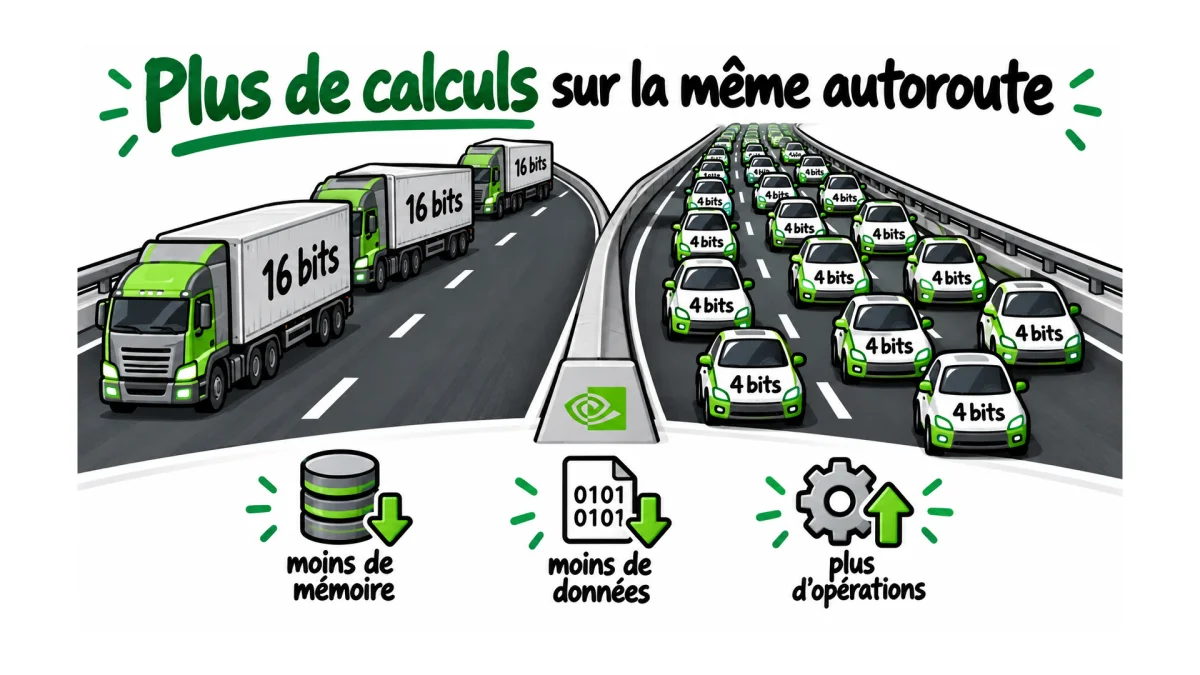
Réduire la taille des nombres n'a d'intérêt que si le hardware est capable d'en profiter — et NVIDIA construit justement ses GPU autour de cette idée. Blackwell supporte déjà énormément les calculs en FP4 : sur le GB200, le débit théorique en FP4 est environ quatre fois supérieur à celui du BF16. Attention, ça ne veut absolument pas dire qu'on va entraîner GPT-6 quatre fois plus vite en appuyant sur un bouton : c'est un débit théorique pour certains types de calcul. Mais ça montre pourquoi NVIDIA s'intéresse autant au FP4.
Pensez à une autoroute : si chaque voiture prend deux fois moins de place, vous pouvez potentiellement en faire passer beaucoup plus sur la même route. Avec des nombres plus petits, c'est pareil : moins de mémoire utilisée, moins de données à déplacer, et un GPU qui effectue plus d'opérations en parallèle. Et c'est là qu'arrive la prochaine génération, Vera Rubin : NVIDIA ne veut visiblement pas seulement supporter le FP4, l'entreprise commence à concevoir une partie de son hardware spécifiquement pour ces très basses précisions. Ça change la façon de regarder les progrès des GPU : pour rendre les IA plus puissantes, il ne suffit pas de construire des puces toujours plus grosses — on peut aussi faire plus de travail avec chaque transistor et chaque cellule de mémoire.
FP4 vs FP8 : ce que ça donne en vrai
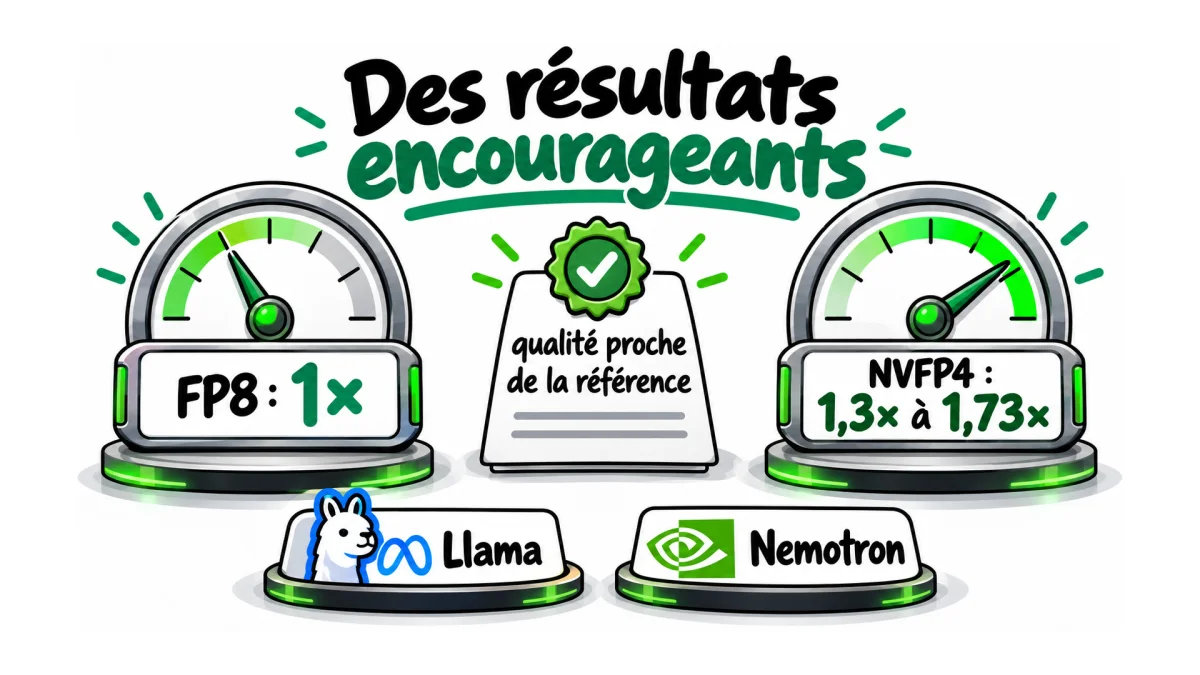
Est-ce qu'un modèle entraîné avec autant de calcul en FP4 reste aussi bon ? Les premiers résultats présentés par NVIDIA sont plutôt encourageants. Sur certaines expériences avec des modèles de la famille Llama, NVIDIA rapporte des accélérations d'environ 1,3 à 1,73 fois par rapport au FP8, tout en restant très proche de la référence en termes de qualité. L'approche est également utilisée sur le modèle Nemotron. NVIDIA vient donc de prouver que le calcul en 4 bits est techniquement possible — et elle essaie réellement d'intégrer cette approche dans la façon dont de très gros modèles sont entraînés.
Mon avis
Soyons honnêtes : il faut encore voir comment tout ça évolue à plus grande échelle, et les chiffres viennent de NVIDIA elle-même. Mais la direction est assez claire. Pendant des années, pour entraîner des IA toujours plus puissantes, on a ajouté plus de GPU, plus de mémoire, plus de puissance brute. Là, NVIDIA travaille carrément dans l'autre sens : passer de 16 à 8 bits, puis de 8 à 4, et construire directement les GPU pour profiter de cette réduction.
Pour moi, c'est le vrai message : la course à l'IA ne se joue plus seulement sur la taille des puces, mais sur l'efficacité avec laquelle on utilise chaque bit de mémoire. C'est d'ailleurs la même logique que celle qu'on retrouve chez Sakana AI pour réduire la mémoire d'entraînement, ou chez les laboratoires chinois qui cherchent à se passer de Nvidia. Si le NVFP4 tient ses promesses sur des modèles géants, NVIDIA aura non seulement vendu des GPU plus puissants — mais aussi changé la façon dont on les utilise.

🎬 Tu préfères la version vidéo ?
Cet article est tiré de ma vidéo YouTube — clique pour la voir.
Regarder sur YouTube →🛠️ Outils que tu peux tester en lien avec cet article
Une sélection de mes outils testés, pertinents pour aller plus loin.
🛠️ Tu cherches des outils IA testés ?
J'ai testé plus de 20 outils IA en vidéo — résumé, mode d'emploi, mon verdict.
Voir mon annuaire d'outils →
Alan Sharif — créateur de Nerdy Kings
Je teste les outils IA et je décrypte les nouveaux modèles pour ma communauté de 20 000+ curieux francophones sur YouTube. Sans bullshit, sans hype, sans jargon.