Jev : Comment Fonctionne Ce Nouveau Modèle IA ?
Depuis quelques jours, un nouveau modèle appelé Jev fait énormément parler de lui. Sur le papier, les résultats sont impressionnants : des réponses en 70 à 500 millisecondes, jusqu'à 200 fois plus rapide que certains LLM, et tellement peu cher que ses créateurs ne facturent même pas la sortie. Beaucoup de gens se demandent maintenant si on a vraiment besoin d'un LLM pour toutes les tâches d'intelligence artificielle. Parce que Jev ne fonctionne pas du tout comme ChatGPT : il n'est pas conçu pour discuter avec vous ou écrire du texte, mais pour faire une chose beaucoup plus précise — prendre énormément de petites décisions, extrêmement rapidement. Et derrière cette idée se cache une approche assez différente de celle prise par l'industrie ces dernières années. Alors, est-ce que Jev mérite vraiment toute cette hype ?
Le problème que Jev essaie de résoudre
Quand vous utilisez GPT, Claude ou Gemini, le modèle génère généralement sa réponse token après token. C'est extrêmement puissant, parce que le modèle peut écrire, coder, raisonner ou utiliser des outils. Mais parfois, c'est complètement excessif. Imaginez que vous ayez 100 000 emails et que vous vouliez simplement savoir lesquels concernent la facturation, le support ou le commercial : un LLM peut parfaitement le faire, mais vous utilisez une énorme machine capable de générer du langage et de raisonner, simplement pour obtenir une catégorie. Et quand votre application doit prendre des millions de petites décisions comme celle-ci, le coût et surtout la latence deviennent un vrai problème.
C'est précisément là qu'intervient TypeSafe AI, une start-up basée à San Francisco qui vient de sortir de deux années de développement dans l'ombre. Elle a été fondée par Diogo Almeida, un ancien chercheur chez OpenAI qui a travaillé sur le RLHF et Instruct-GPT, avec Eric Gafni et Sasa Sheng. L'entreprise vient de lever 40 millions de dollars pour développer une nouvelle catégorie de modèles : les System One Models. Le nom vient de la distinction popularisée par Daniel Kahneman : le système 2, lent et délibératif, et le système 1, rapide et intuitif. Les gros modèles ressemblent de plus en plus au système 2 — on leur donne du temps pour raisonner, utiliser des outils, vérifier leur travail. Jev cherche à faire l'inverse : pas réfléchir longtemps, décider rapidement.
Comment Jev fonctionne concrètement
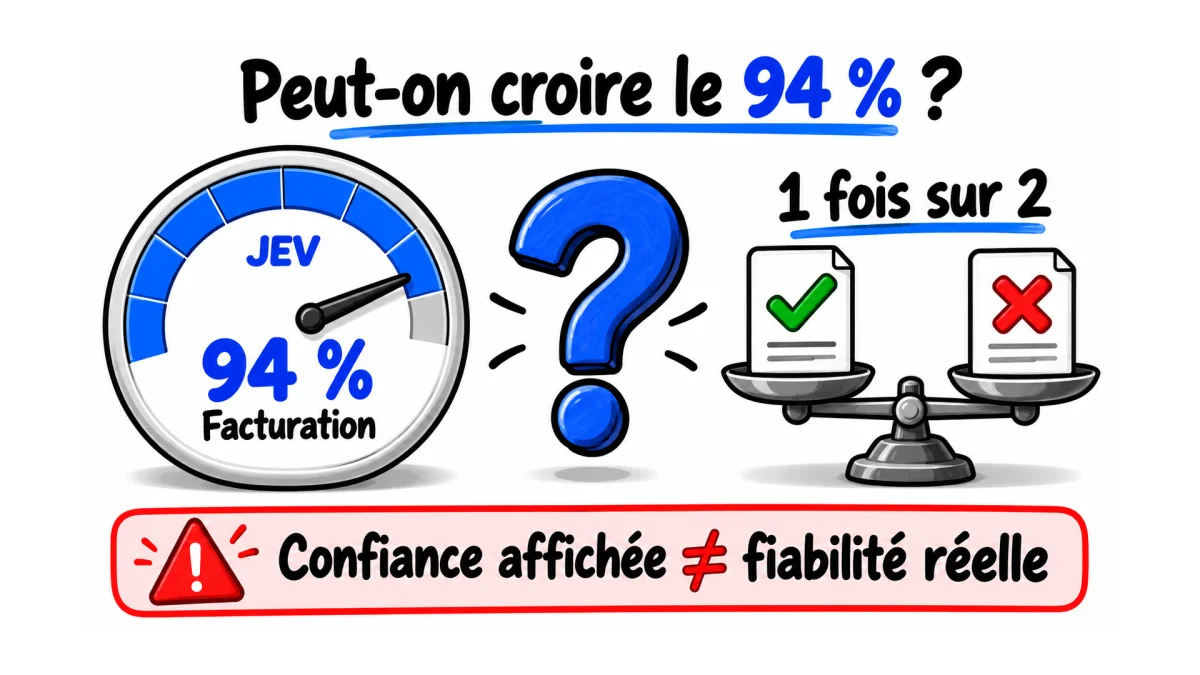
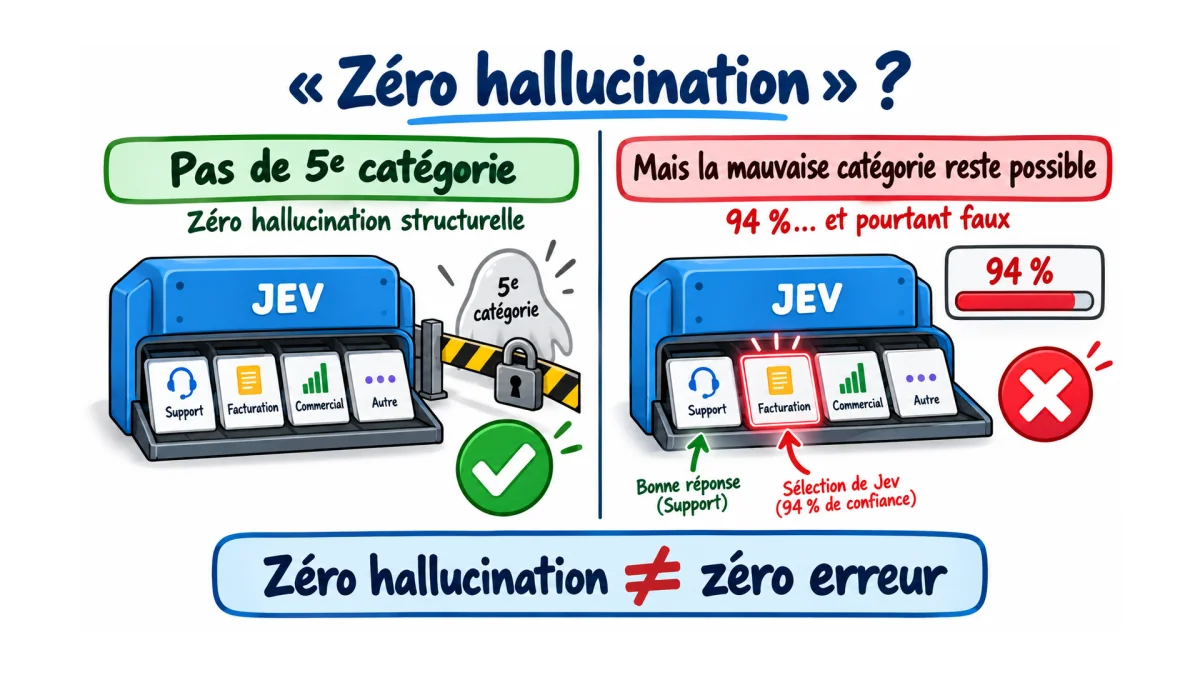
Reprenons l'exemple des emails. Avec un LLM classique, vous pourriez lui dire : « Lis cet email et dis-moi s'il doit aller au support, à la facturation ou au commercial. » Le modèle va générer sa réponse, même si au final vous voulez juste une catégorie. Avec Jev, vous lui donnez directement les choix possibles — support, facturation, commercial ou autre — et il attribue une probabilité à chacun : par exemple 94 % pour la facturation, 3 % support, 2 % commercial, 1 % autre. Et c'est tout. Comme les réponses sont définies à l'avance, Jev ne peut pas soudainement inventer une cinquième catégorie.
TypeSafe propose trois types de décisions : choice pour choisir entre plusieurs possibilités, score pour donner une note sur une échelle, et nul pour une question de type oui ou non. Et surtout, Jev peut traiter plusieurs questions autour du même contexte en parallèle : sur un même email, on pourrait lui demander en même temps à quel service l'envoyer, à quel point le client est énervé, et si c'est vraiment urgent. Sur des milliers, voire des millions de données, la différence devient très intéressante.
Le RLCD : rendre les probabilités réellement fiables
Il reste quand même un problème : si Jev annonce 94 % pour la facturation, est-ce que ce chiffre est vraiment fiable ? Si le modèle affiche 94 % alors qu'il se trompe une fois sur deux, cette probabilité ne sert pas à grand-chose. C'est là qu'intervient le RLCD, pour Reinforcement Learning for Calibrated Decisions. L'idée est simple : Jev ne doit pas seulement apprendre à donner la bonne réponse, il doit aussi estimer à quel point on peut lui faire confiance. Si sur des centaines de décisions similaires Jev annonce 70 %, on voudrait qu'il ait effectivement raison environ 7 fois sur 10 — c'est ce qu'on appelle une probabilité calibrée.
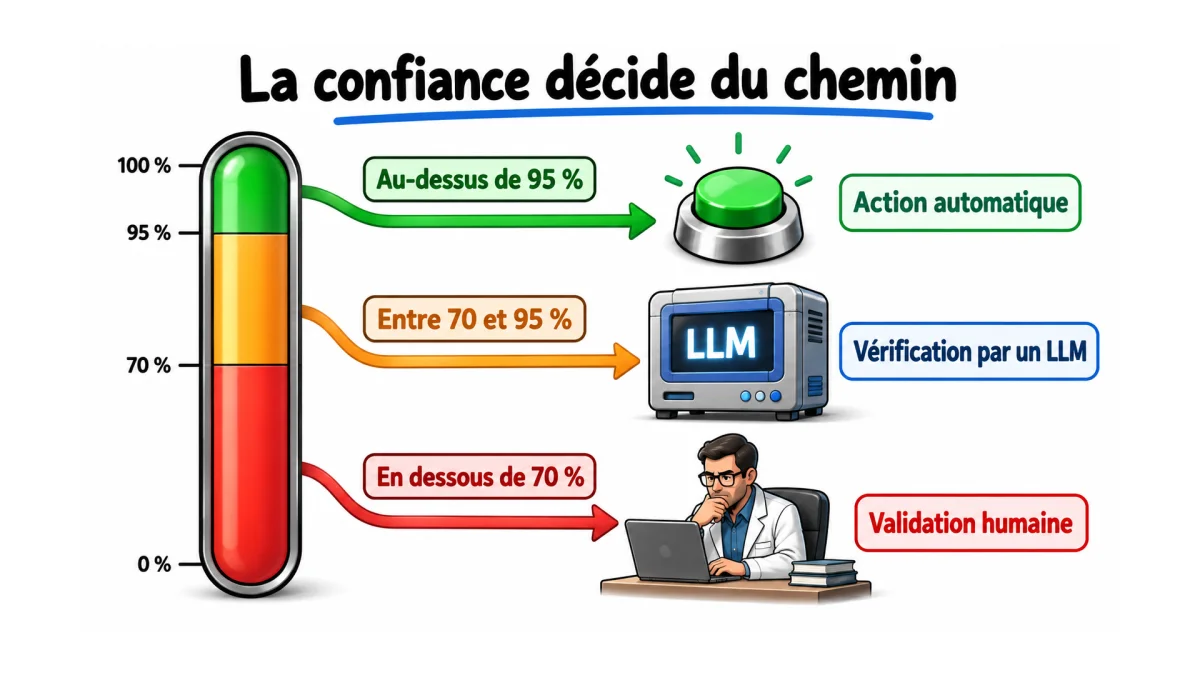
Pour l'automatisation, c'est très intéressant : on pourrait décider qu'au-dessus de 95 %, on exécute directement l'action ; entre 70 et 95 %, on demande à un modèle plus puissant de vérifier ; et en dessous, on envoie ça à un humain. C'est probablement la meilleure façon de comprendre Jev : c'est presque un if intelligent. Le code gère ce qui est prévisible, Jev prend les petites décisions où il faut comprendre le contexte, et les gros LLM n'interviennent que lorsqu'il faut vraiment raisonner ou générer quelque chose.
70 à 500 millisecondes, et une sortie gratuite
On comprend maintenant beaucoup mieux pourquoi Jev est aussi rapide. Au lieu de générer une longue réponse token par token, il produit directement ses décisions. TypeSafe annonce des réponses généralement entre 70 et 500 millisecondes, avec une médiane autour de 100 ms. Mais c'est surtout au niveau du prix que c'est le plus impressionnant : environ 0,042 $ par million de tokens en entrée, et la sortie n'est même pas facturée. Selon ses propres comparaisons, TypeSafe parle de jusqu'à 200 fois plus rapide et 400 fois moins cher. Attention cependant, ce sont surtout des chiffres sur des tâches particulièrement adaptées à Jev — ça ne veut absolument pas dire qu'il sera 200 fois plus rapide dans toutes les situations.
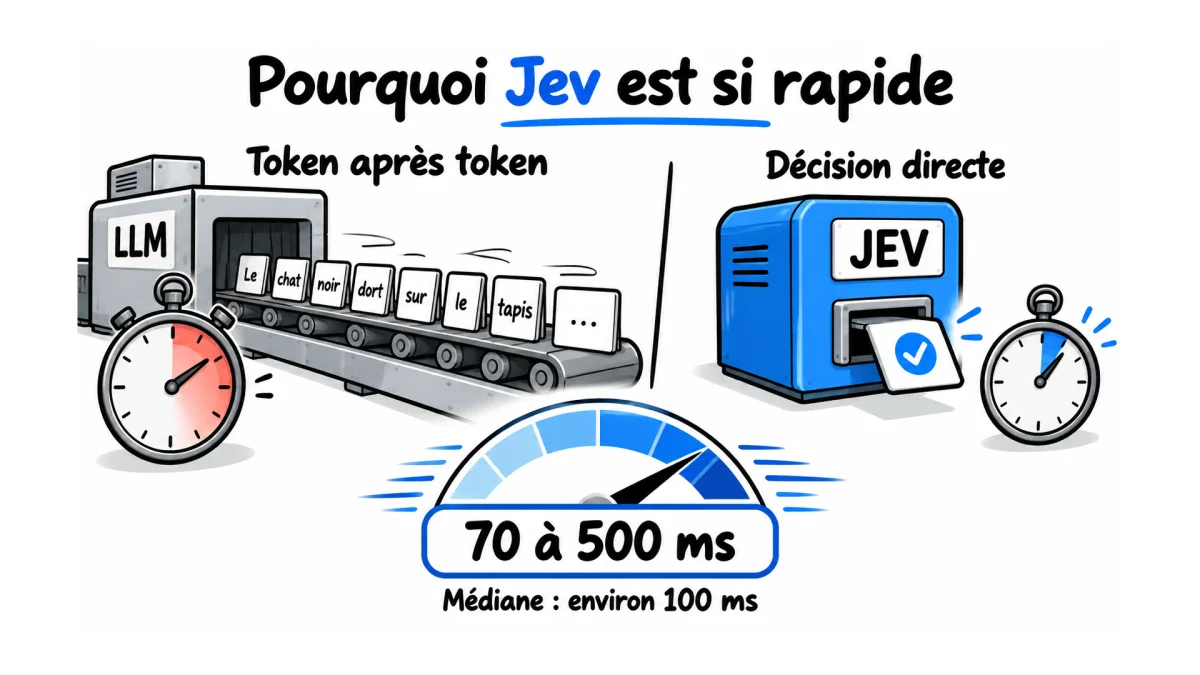
Un test extérieur à TypeSafe donne un exemple plus concret : sur une tâche consistant à retrouver plusieurs problèmes cachés dans un document, Jev a répondu en médiane en 0,35 seconde, contre 8,83 secondes pour Fable 5.1 — environ 25 fois plus rapide. Mais Jev a trouvé 6 problèmes sur 7, contre 7 sur 7 pour Fable. Ça résume plutôt bien le compromis : beaucoup plus rapide et beaucoup moins cher, mais pas forcément plus intelligent.
À quoi ça sert vraiment — et à quoi ça ne sert pas
Jev n'est vraiment pas un concurrent direct de GPT ou Claude, même si on a pu voir passer ce raccourci plusieurs fois sur YouTube et X. Son intérêt apparaît surtout quand il faut répéter énormément de fois une petite décision : créer des documents, modérer du contenu, router des requêtes, évaluer les réponses d'un LLM ou vérifier les actions d'un agent. Des développeurs l'ont même utilisé pour contrôler des agents dans Minecraft, Doom, Subway Surfer ou dans un simulateur de drone, à environ 10 décisions par seconde. Le but n'est pas de remplacer un LLM, mais de faire certaines tâches plus rapidement, pour moins cher, et surtout de pouvoir le répéter à très grande échelle.
Et non, Jev n'a rien d'un OVNI. Faire de la classification sans générer de texte, ce n'est pas nouveau : bien avant GPT, des modèles comme BERT étaient déjà utilisés pour ce genre de tâche, et depuis Jev, plusieurs développeurs ont commencé à reproduire des approches similaires avec des modèles open source. Ce qui rend Jev intéressant, c'est d'avoir réuni cette approche dans une infrastructure très rapide, avec une API standardisée et des probabilités que TypeSafe cherche à rendre fiables grâce au RLCD.
Dernière nuance importante : beaucoup de gens disent que Jev ne peut pas halluciner. C'est vrai, mais dans un sens très précis. Si vous lui donnez quatre catégories, Jev ne peut pas en inventer une cinquième — ce qu'on pourrait appeler les hallucinations structurelles disparaissent. Mais Jev peut toujours choisir la mauvaise catégorie, et se tromper même avec beaucoup de confiance affichée. Zéro hallucination ne veut absolument pas dire zéro erreur.
Mon avis
Est-ce que Jev mérite réellement toute la hype autour de lui en ce moment ? Je dirais oui, mais pas forcément pour toutes les raisons qu'on voit partout. Il n'a pas inventé la classification, il n'est pas plus intelligent que GPT ou Claude, et le fameux « zéro hallucination » est à prendre avec de sérieuses pincettes. Ce qui est vraiment intéressant avec Jev, c'est le mouvement inverse qu'il propose : au lieu de nous sortir un bon gros modèle capable de tout faire, TypeSafe propose l'exact opposé — un modèle très spécialisé, extrêmement rapide et presque gratuit à utiliser.
Et si ça fonctionne à grande échelle, ça peut être le début d'une nouvelle génération de petits modèles très spécialisés, chacun chargé d'un type de décision précis, pendant que les gros LLM s'occupent des tâches les plus complexes. C'est un peu la même logique de fond qu'on retrouve derrière les agents qui pensent sans mots ou les architectures pensées pour aller plus vite plutôt que plus gros : la course à la taille n'est plus la seule qui compte. Reste à voir si TypeSafe tiendra ses promesses de fiabilité à grande échelle une fois que tout le monde aura pu tester ça sur ses propres données — pour l'instant, on n'a que les chiffres de TypeSafe et un seul test indépendant.

🎬 Tu préfères la version vidéo ?
Cet article est tiré de ma vidéo YouTube — clique pour la voir.
Regarder sur YouTube →🛠️ Outils que tu peux tester en lien avec cet article
Une sélection de mes outils testés, pertinents pour aller plus loin.
🛠️ Tu cherches des outils IA testés ?
J'ai testé plus de 20 outils IA en vidéo — résumé, mode d'emploi, mon verdict.
Voir mon annuaire d'outils →
Alan Sharif — créateur de Nerdy Kings
Je teste les outils IA et je décrypte les nouveaux modèles pour ma communauté de 30 000+ curieux francophones sur YouTube. Sans bullshit, sans hype, sans jargon.